 АвторMetatag Digital
Файл robots.txt — это фундаментальный инструмент в арсенале любого веб-мастера и SEO-специалиста. Несмотря на свой небольшой размер и простой формат, он играет важную роль во взаимодействии вашего сайта с поисковыми роботами. В этой статье мы детально разберем все аспекты этого файла: от базовых понятий до сложных правил с использованием регулярных выражений.
Содержание
- Что такое robots.txt и для чего он нужен?
- Подробный разбор всех директив robots.txt
- Примеры готовых файлов robots.txt
- Регулярные выражения в robots.txt
- Что стоит закрывать в robots.txt, а что нет?
- Заключение
Что такое robots.txt и для чего он нужен?
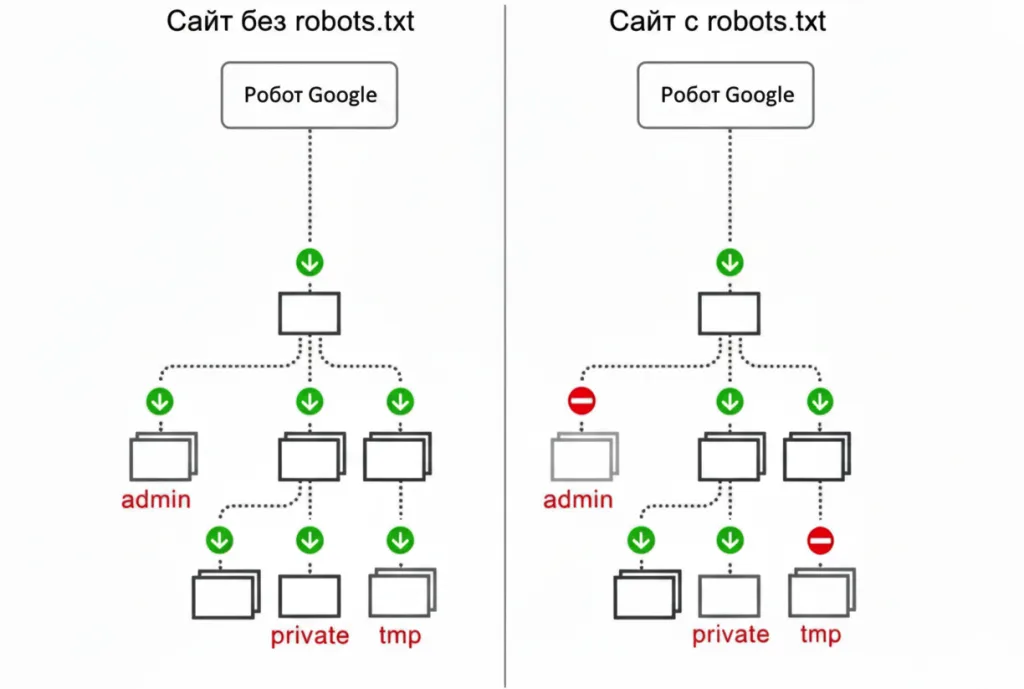
Robots.txt — это текстовый файл, расположенный в корневой директории вашего сайта (например, https://vash-sait.com/robots.txt). Он служит сводом правил для веб-роботов (краулеров), сообщая им, какие разделы или файлы сайта можно сканировать, а какие — нет.
Этот файл не является строгим предписанием, а скорее просьбой к роботам (таким как Googlebot, Yandex и др.). Большинство авторитетных поисковых систем следуют этим правилам, но злонамеренные боты (например, сканеры email-адресов, хакерские скрипты) могут их просто проигнорировать.
Основные цели robots.txt:
- Управление краулер-бюджетом: Помогает направить внимание поисковых роботов на самые важные страницы, предотвращая их трату времени на сканирование служебных или технических разделов (например, админ-панелей, страниц с фильтрами).
- Сокрытие конфиденциального контента: Позволяет закрыть от индексации страницы, которые не должны появляться в поиске (например, служебные файлы, дубли контента, страницы в разработке).
- Предотвращение индексации внутренних файлов: Запрещает сканирование файлов CSS, JavaScript и изображений, если вы не хотите, чтобы они отображались в результатах поиска как отдельные документы.
- Указание на карту сайта: Позволяет в одном месте указать роботам путь к XML Sitemap.
Подробный разбор всех директив robots.txt
Файл robots.txt состоит из одного или нескольких блоков правил. Каждый блок начинается с директивы User-agent и содержит инструкции Disallow и/или Allow.
1. User-agent
Эта директива определяет, для какого именно робота предназначены последующие правила.
- User-agent: * — символ звездочки (*) означает "любой робот". Это самый распространенный вариант, который задает правила для всех краулеров по умолчанию.
- User-agent: Googlebot — правила будут применены только к основному краулеру Google для обычного поиска.
- User-agent: Googlebot-Image — правила только для краулера Google, отвечающего за индексацию изображений.
- User-agent: Yandex — правила только для поискового робота Яндекса.
В одном файле может быть несколько блоков User-agent. Робот прочитает файл сверху вниз и будет следовать правилам из первого блока, который соответствует его имени, или из блока User-agent: *, если для него нет специальных указаний.
2. Disallow
Директива, которая запрещает сканирование указанного пути.
- Disallow: (пустое значение) — Разрешает сканирование ВСЕГО сайта. Это значение по умолчанию, если файл robots.txt отсутствует.
- Disallow: / — Запрещает сканирование ВСЕГО сайта. Будьте осторожны с этой настройкой!
- Disallow: /admin/ — Запрещает сканирование всей папки /admin и всего ее содержимого.
- Disallow: /private.html — Запрещает сканирование конкретного файла private.html.
3. Allow
Директива, которая разрешает сканирование пути, даже если он попадает под запрет Disallow в этом же блоке. Она используется для создания исключений.
- Allow: /uploads/photos/public.jpg — Разрешает сканирование конкретного файла, даже если папка /uploads закрыта.
- Пример с исключением:
robots.txt
User-agent: *
Disallow: /uploads/
Allow: /uploads/logo.png
В этом случае роботу запрещено сканировать всю папку /uploads/, кроме файла logo.png внутри нее.
4. Sitemap
Эта директива указывает роботам на местоположение XML Sitemap (карты сайта). Ее можно разместить в любом месте файла, но обычно ее ставят в начало или конец.
- Sitemap: https://vash-sait.com/sitemap.xml
- Можно указать несколько карт сайта, если они у вас есть.
5. Другие директивы (Crawl-delay, Clean-param)
- Crawl-delay — задает паузу (в секундах) между загрузками страниц для робота. Это помогает снизить нагрузку на сервер. Примечание: Google больше не поддерживает эту директиву, вместо нее следует использовать настройку в Search Console. Но ее понимают другие роботы, например, Yandex.
Crawl-delay: 2 — робот будет ждать 2 секунды между запросами.
- Clean-param (специфична для Yandex) — указывает роботу Яндекса, что определенные параметры URL (например, ?sessionid или ?referrer) не меняют содержимое страницы, и их можно не учитывать для избежания дублей.
Clean-param: sid /forum/showthread.php — для всех URL, начинающихся с /forum/showthread.php, параметр sid игнорируется.
Примеры готовых файлов robots.txt
Пример 1: Базовый и самый распространенный
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /includes/
Disallow: /tmp/
Disallow: /private-files/
Sitemap: https://vash-sait.com/sitemap.xml
Разрешает сканирование всего сайта, кроме нескольких служебных папок.
Пример 2: Для WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-includes/
Disallow: /readme.html
Disallow: /refer/
Disallow: /cgi-bin/
Disallow: *?s=
Disallow: *&s=
Disallow: /search/
Sitemap: https://vash-sait.com/sitemap_index.xml
Закрывает служебные папки WordPress, файл readme и страницы поиска, чтобы избежать дублей.
Регулярные выражения в robots.txt
Стандарт файла robots.txt изначально не поддерживал регулярные выражения в их полном объеме. Однако основные поисковые системы (Google, Yandex) понимают некоторые специальные символы, которые позволяют создавать гибкие правила.
Основные символы:
- *— Звездочка. Обозначает любую последовательность символов (включая пустую строку).
Disallow: /*.pdf — Запрещает сканирование всех PDF-файлов на всем сайте.
- Disallow: /temp* — Запрещает все URL, которые начинаются с /temp (например, /temp, /temporary, /temp123.html).
- $— Знак доллара. Обозначает конец строки. Используется для точного совпадения.
Disallow: /*.php$ — Запрещает сканирование URL, которые заканчиваются на .php, но разрешит *.php?page=1, так как после .php есть другие символы.
- Комбинация*и$:
Disallow: /bin/*.aspx$ — Запрещает все файлы .aspx в папке /bin/.
Важно: Яндекс официально поддерживает более сложные регулярные выражения (например, [a-z], +, ?), в то время как Google придерживается в основном * и $. Для максимальной совместимости лучше использовать только эти два символа.
Что стоит закрывать в robots.txt, а что нет?
Это один из самых важных вопросов, так как ошибка может скрыть от поисковиков важный контент.
Закрывать (Disallow)
- Служебные и системные папки: /admin/, /wp-admin/, /includes/, /config/, /cp/.
- Скрипты и исполняемые файлы: /cgi-bin/, /scripts/.
- Файлы для разработчиков: readme.html, /installation/, /test/.
- Страницы с фильтрами и сортировкой: disallow: /*?sort=*, Disallow: /*?filter_* (чтобы избежать дублей).
- Страницы поиска на сайте:Disallow: /search/, Disallow: *?s=.
- Служебные файлы CMS: /phpmyadmin/, /server-status/.
- Дублирующийся контент: Версии страниц для печати (*?print=yes), параметры сессий.
Не закрывать (или быть очень осторожным)
- CSS и JS файлы. Почему? Современные поисковые системы (особенно Google) используют CSS и JavaScript для правильного отображения страницы и понимания ее содержимого. Если вы заблокируете их в robots.txt, Google может не увидеть ваш сайт таким, каким его видят пользователи, что негативно скажется на индексации и ранжировании. Вместо запрета убедитесь, что эти файлы доступны для сканирования.
- Основные изображения товаров, статей. Если вы хотите, чтобы они участвовали в поиске по картинкам.
- Важные страницы и разделы. Убедитесь, что ни одно правило случайно не блокирует доступ к ключевым URL.
- Файлsitemap.xml. Он должен быть всегда доступен.
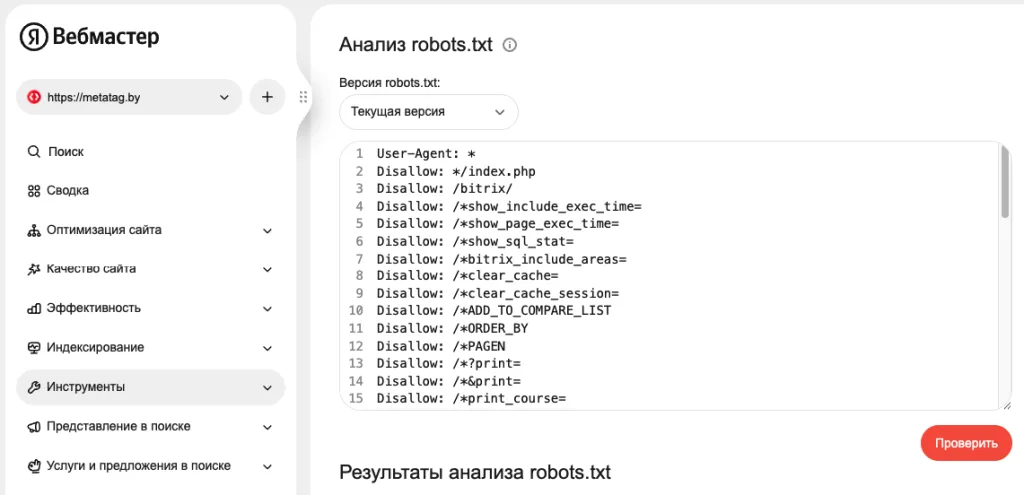
Как проверить свой robots.txt?
- Вручную: Перейдите на your-site.com/robots.txt.
- Вебмастер Яндекс: Инструмент "Анализ robots.txt" позволяет тестировать правила и видеть, как Yandex их интерпретирует.
- Сторонние онлайн-валидаторы.
Заключение
Файл robots.txt — это не просто формальность, а мощный инструмент технической оптимизации. Правильно настроенный, он помогает поисковым системам эффективнее работать с вашим сайтом, экономит краулер-бюджет и защищает конфиденциальные данные. Регулярно перепроверяйте его, особенно после крупных обновлений сайта, чтобы быть уверенным, что все важные страницы открыты для индексации, а все лишнее — надежно скрыто.